シェーダーのベストプラクティス
OpenGL ES 2.0以降では、プログラマブルパイプラインが利用可能なため、アプリケーションはシェーダープログラムの実行にかなりの時間を費やします。特にモバイルおよび組み込みハードウェアでは、シェーダーがパフォーマンスのボトルネックやグラフィカルなアーティファクトの原因となることがあります。適切に使用すれば、シェーダーはCPUとGPUの間で計算を分散させることにより、驚くべきグラフィカル品質とパフォーマンスを実現するのに役立ちます。計算をフラグメントシェーダーで行うか、頂点シェーダーで行うかを決定する必要があります。
シェーダープログラムの頂点シェーダーは各頂点ごとに一度実行され、フラグメントシェーダーは各ピクセルごとに一度実行されます。通常、ピクセルの数は頂点の数よりも桁違いに多いです。このため、ベストプラクティスとしては、頂点シェーダーで可能な限り多くの計算を行い、その結果をフラグメントシェーダーで使用することです。
ジオメトリシェーダーとテッセレーションシェーダーを使用するには、Kanzi アプリケーションを実行したいハードウェアが OpenGL ES 3.2 をサポートしている必要があります。ジオメトリシェーダーとテッセレーションシェーダーは、タイルレンダリングアーキテクチャでパフォーマンスを低下させる可能性があることに注意してください。このため、モバイルおよび組み込みハードウェアではジオメトリシェーダーとテッセレーションシェーダーの使用を避けることが推奨されます。
最もよく発生するシェーダーのボトルネックには以下のとおりです。
フラグメントシェーダーでの不必要な計算と、負荷が高いフラグメントシェーダー。フラグメントシェーダーの最適化 を参照してください。
長い頂点シェーダーを持つ3Dモデル。頂点シェーダーがボトルネックである場合、パフォーマンスを向上させるために命令の数を減らしてください。フラグメントシェーダーがボトルネックである場合、頂点シェーダーでの最適化はパフォーマンスに影響を与えません。
多数のピクセルをフィルする必要がある多数のフラグメントを使用した表示。
GPUに送信され、頂点シェーダーによって処理される頂点。三角形の数は、フレームごとに描画される頂点数のヒントを提供します。アプリケーションのパフォーマンスのトラブルシューティング を参照してください。
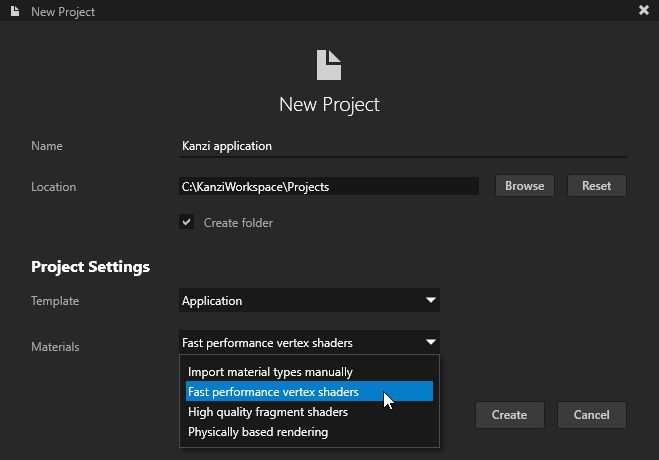
Kanzi Studio は、異なるシェーダープロファイル用のこれらのテンプレートを提供します。
High performance vertex shaders テンプレートは、低精度で高パフォーマンスの OpenGL ES2 アプリケーション向けに設計されています。これは、OpenGL ES2 での使用に最適化された頂点ベースのシェーダーを含んでいます。Phong 反射モデルを使用したライティングの適用を含む、GPU 固有の計算のほとんどは頂点シェーダーで行われます。これは、ほとんどのデバイスにとって良い出発点です。
High performance vertex shaders マテリアルタイプで提供される頂点ベースのシェーディングは、頂点ベースのシェーディングのコストが低いため、モバイルGPUにとって良い選択です。
High quality fragment shaders テンプレートは、高精度の OpenGL ES2 アプリケーション向けに設計されています。これは、OpenGL ES2 で使用するためのピクセルシェーダーベースのマテリアルを含んでいます。Phong 反射モデルを使用したライティングの適用を含む、GPU 固有の計算のほとんどはフラグメントシェーダーで行われます。これにより、しばしばパフォーマンスを犠牲にして、より良い画像品質が提供されます。
Physically based rendering テンプレートは、OpenGL ES3 アプリケーション向けに設計されています。これは、物理ベースレンダリング (PBR) の原則を実装したシェーダーに基づくマテリアルを含んでいます。これらのマテリアルのプロパティは、メタルネスのような物理的特性を表しており、直感的に制御できます。物理ベースのライティングモデルを使用したライトの適用を含む、GPU 固有の計算のほとんどはフラグメントシェーダーで行われます。これにより、多くのライティング条件でより現実的なレンダリング結果が得られます。
グラフィックスハードウェアとシーンの複雑さによって、シェーダーはアプリケーションのパフォーマンスに大きな影響を与えることがあります。
シェーダーで使用される uniform および varying 属性の精度を下げることで、パフォーマンスを最適化できます。シェーダーの精度は GLES 固有のものです。
モバイルおよび組み込みデバイスの場合、使用します:
[-2..2] の範囲のすべての変数に対して低精度。
32ビット浮動小数点の完全な精度を必要としない他の変数には中精度を使用します。
シェーダーはマテリアル固有です。Kanzi Studio でシェーダーを直接変更できます。シェーダーを編集する を参照してください。
Kanzi アプリケーションでシェーダーを使用するためのベストプラクティスは次のとおりです。
精度を減らし、計算をフラグメントからバーテックスに移すことで、フラグメントシェーダーを最適化します。フラグメントシェーダーの最適化 を参照してください。
シェーダープログラム間の過剰なスイッチングが必要になるような順序でノードが提示されると、レンダリング速度が低下する可能性があります。シェーダースイッチの削減 を参照してください。
Kanzi Studio にコードをコンパイルさせ、シェーダーをバイナリ形式でエクスポートします。これにより、アプリケーションの読み込み時間が短縮されます。バイナリシェーダーを使用すること を参照してください。
ユーザーがマルチコアプロセッサを備えた環境で Kanzi アプリケーションを実行すると、Kanzi は自動的に複数のCPUコアを使用して、kzbファイル内のGPUリソースをRAMにロードします。
Kanzi は、アプリケーションで使用するコアの数を設定することができます。リソースを並列でロードする を参照してください。
シェーダーが使用するライトの量のみを計算するようにしてください。アプリケーション内の Scene ノードのライトの数を、シェーダーが計算する量に制限してください。
PVRShaderEditor などのシェーダーツールを使って、シェーダーのパフォーマンスコストに関する包括的な情報を得ます。
シェーダーでエラーや警告がないことを確認します。
複数のシェーダーで使用したい機能は、別々のシェーダーに配置し、そのシェーダーコードを再利用してください。シェーダーコードの再利用 を参照してください。
関連項目
Kanzi Engine が未使用のリソースをどのように処理するかを設定する